
Ich verbringe die meiste Zeit damit, KI-Systeme zu bauen. Der Großteil dieser Arbeit ist Engineering: verschiedene Lösungen über die passenden Protokolle verbinden und den Kontext für die jeweilige Aufgabe managen. Das Modell selbst auszuwählen macht dabei nur einen kleinen Teil meiner Zeit aus.
Oft fragen mich Marketing-Teams, welche KI-Lösung denn nun die beste ist. Claude, ChatGPT oder Copilot? Das richtige Modell ist schon eine Weile nicht mehr die entscheidende Variable. Es ist der Teil eures Setups, auf den ihr am wenigsten Einfluss habt und um den ihr euch am wenigsten Sorgen machen müsst. Was ihr in der Hand habt, ist das, was das Modell zu sehen bekommt und womit es arbeitet.
Unten habe ich ein paar Grundbegriffe aufgeschrieben. Damit werdet ihr schnell souveräner im Umgang mit KI.
Was macht ein Large Language Model eigentlich?
Es sagt das nächste Wort in einer Sequenz voraus, auf Basis der Wörter, die es schon bekommen hat. Alles andere, was ihr über schreibende, denkende oder planende KI gehört habt, baut auf dieser einen Operation auf. Im Kern ist es eine gigantische Maschine, die Wörter vorhersagt.
Die aktuellen Spitzenmodelle kommen alle mit solidem Allgemeinwissen. OpenAI, Google und Anthropic haben sie auf einer riesigen Bandbreite menschlicher Texte trainiert. Sie wissen also etwas über Polymerchemie, etwas über Renaissance-Malerei und etwas über eure Branche. Und mit jedem Release werden sie besser.
Das macht sie, ganz nüchtern betrachtet, zur Commodity: Euer Wettbewerber kauft dieselbe Modellqualität wie ihr, ungefähr zum selben Preis, am selben Tag.
Euer Wettbewerber kauft dieselbe Modellqualität wie ihr, ungefähr zum selben Preis, am selben Tag.
Was ist Kontext?
Kontext ist alles, was das Modell sehen kann, wenn es eure Anfrage beantwortet. Eure Frage selbst, die Dateien, die ihr angehängt habt, die Beispiele, die ihr reinkopiert habt, und vor allem die Systeme, die ihr mit dem Modell verbunden habt.
Marketing-Teams meinen mit Kontext oft nur das Hintergrundmaterial, das sie der KI mitgeben. Das ist ein Teil davon. Die technische Definition umfasst aber das ganze Sichtfeld des Modells: auch die Teile, die automatisch ankommen, und die, die ihr nie zu sehen bekommt.
Der Unterschied ist wichtig, weil sich damit ändert, worum ihr euch kümmern müsst.
Ein Modell neu zu trainieren ist für die meisten Firmen wirtschaftlich schlicht nicht drin. Den Kontext zu managen, den ihr mitgebt, ist deshalb euer stärkster Hebel für gute Ergebnisse.
Was ist ein Kontextfenster?
Das Kontextfenster ist die maximale Textmenge, die ein Modell auf einmal im Blick behalten kann. Geht ihr drüber hinaus, fällt das früheste Material raus.
Die Kontextfenster sind mit jeder Modellgeneration gewachsen. Ein Dokument, das ein System vor zwei Jahren überfordert hat, könnt ihr heute einfach einfügen oder hochladen. Inzwischen verarbeiten Modelle alle sieben Harry-Potter-Bände auf einmal. Ob ihr für ein Abo zahlt oder nicht, ist dabei egal. Das ist eine Eigenschaft des Modells selbst.
Neben der Menge spielt die Qualität eine große Rolle. Wenn ihr Informationen im Kontext mitschleppt, die mit eurer Aufgabe nichts zu tun haben, wird euer Output schlechter. Das Phänomen heißt Context Rot.
Ein Tipp für die Praxis: Wenn ein langer Chat anfängt, Details zu ignorieren, die ihr am Anfang festgelegt habt, dann seid ihr wahrscheinlich genau da gelandet.
Was ist KI-Slop?
Slop ist KI-Output, der kompetent klingt und nichts sagt. Die Grammatik stimmt, die Struktur wirkt vernünftig, das Vokabular ist professionell, und verwertbare Information ist keine drin. Ihr erkennt ihn oft an den vielen Füllwörtern, die nichts bedeuten, und am Gedankenstrich (—), der Sätze künstlich in die Länge zieht.
Die meisten B2B-Marketing-Teams, die ein Chat-Tool im großen Stil ausgerollt haben, haben Slop produziert, ob sie es zugeben wollen oder nicht. Überflogen wirken die ersten Entwürfe oft okay. Aber wenn man den Text wirklich liest, na ja, dann muss er neu geschrieben werden. Und sobald eine Kollegin das Umschreiben übernimmt, ist der vermeintliche Effizienzgewinn schnell wieder weg.
Was ist eine Halluzination?
Eine Halluzination ist eine selbstbewusst vorgetragene Behauptung, die das Modell erfunden hat. Dazu gehören erfundene Quellenangaben, Verweise auf Kunden, die es nicht gibt, oder Spezifikationen, die nie veröffentlicht wurden.
Das Modell erzeugt eine Halluzination genauso, wie es eine wahre Aussage erzeugt: Es sagt plausible Wörter voraus. Einen eigenen Mechanismus, der prüft, ob das Ergebnis stimmt, hat es nicht.
Slop und Halluzinationen brauchen unterschiedliche Gegenmittel. Eine Halluzination erwischt ihr, indem ihr die Behauptung mit einer Quelle abgleicht. Slop marschiert durch diesen Check einfach durch, weil er sich selten auf etwas festlegt, das konkret genug wäre, um falsch zu sein.
Was das Modell sieht, habt ihr in der Hand.
Was ist Fachwissen?
Fachwissen ist das, was euer Team weiß und das Modell nicht: eure Markensprache, eure Begriffe, die echten Fragen eurer Kunden, der Grund, warum eine Entscheidung 2023 in die eine Richtung ging und letztes Quartal in die andere. Es sollte den größten Teil des Kontexts ausmachen, den ihr eurem Modell mitgebt.
Stellt euch eine Senior-Marketerin vor, die neu zu euch kommt. Sie bringt 20 Jahre Erfahrung und ein exzellentes Urteilsvermögen mit, und am ersten Tag weiß sie nichts über euren Markt und eure Accounts. Das Modell sitzt dauerhaft in dieser Position. Nur schnappt es nebenbei nie etwas auf, weil es Kultur und Kollegen nicht miterlebt.
Was ist ein Skill?
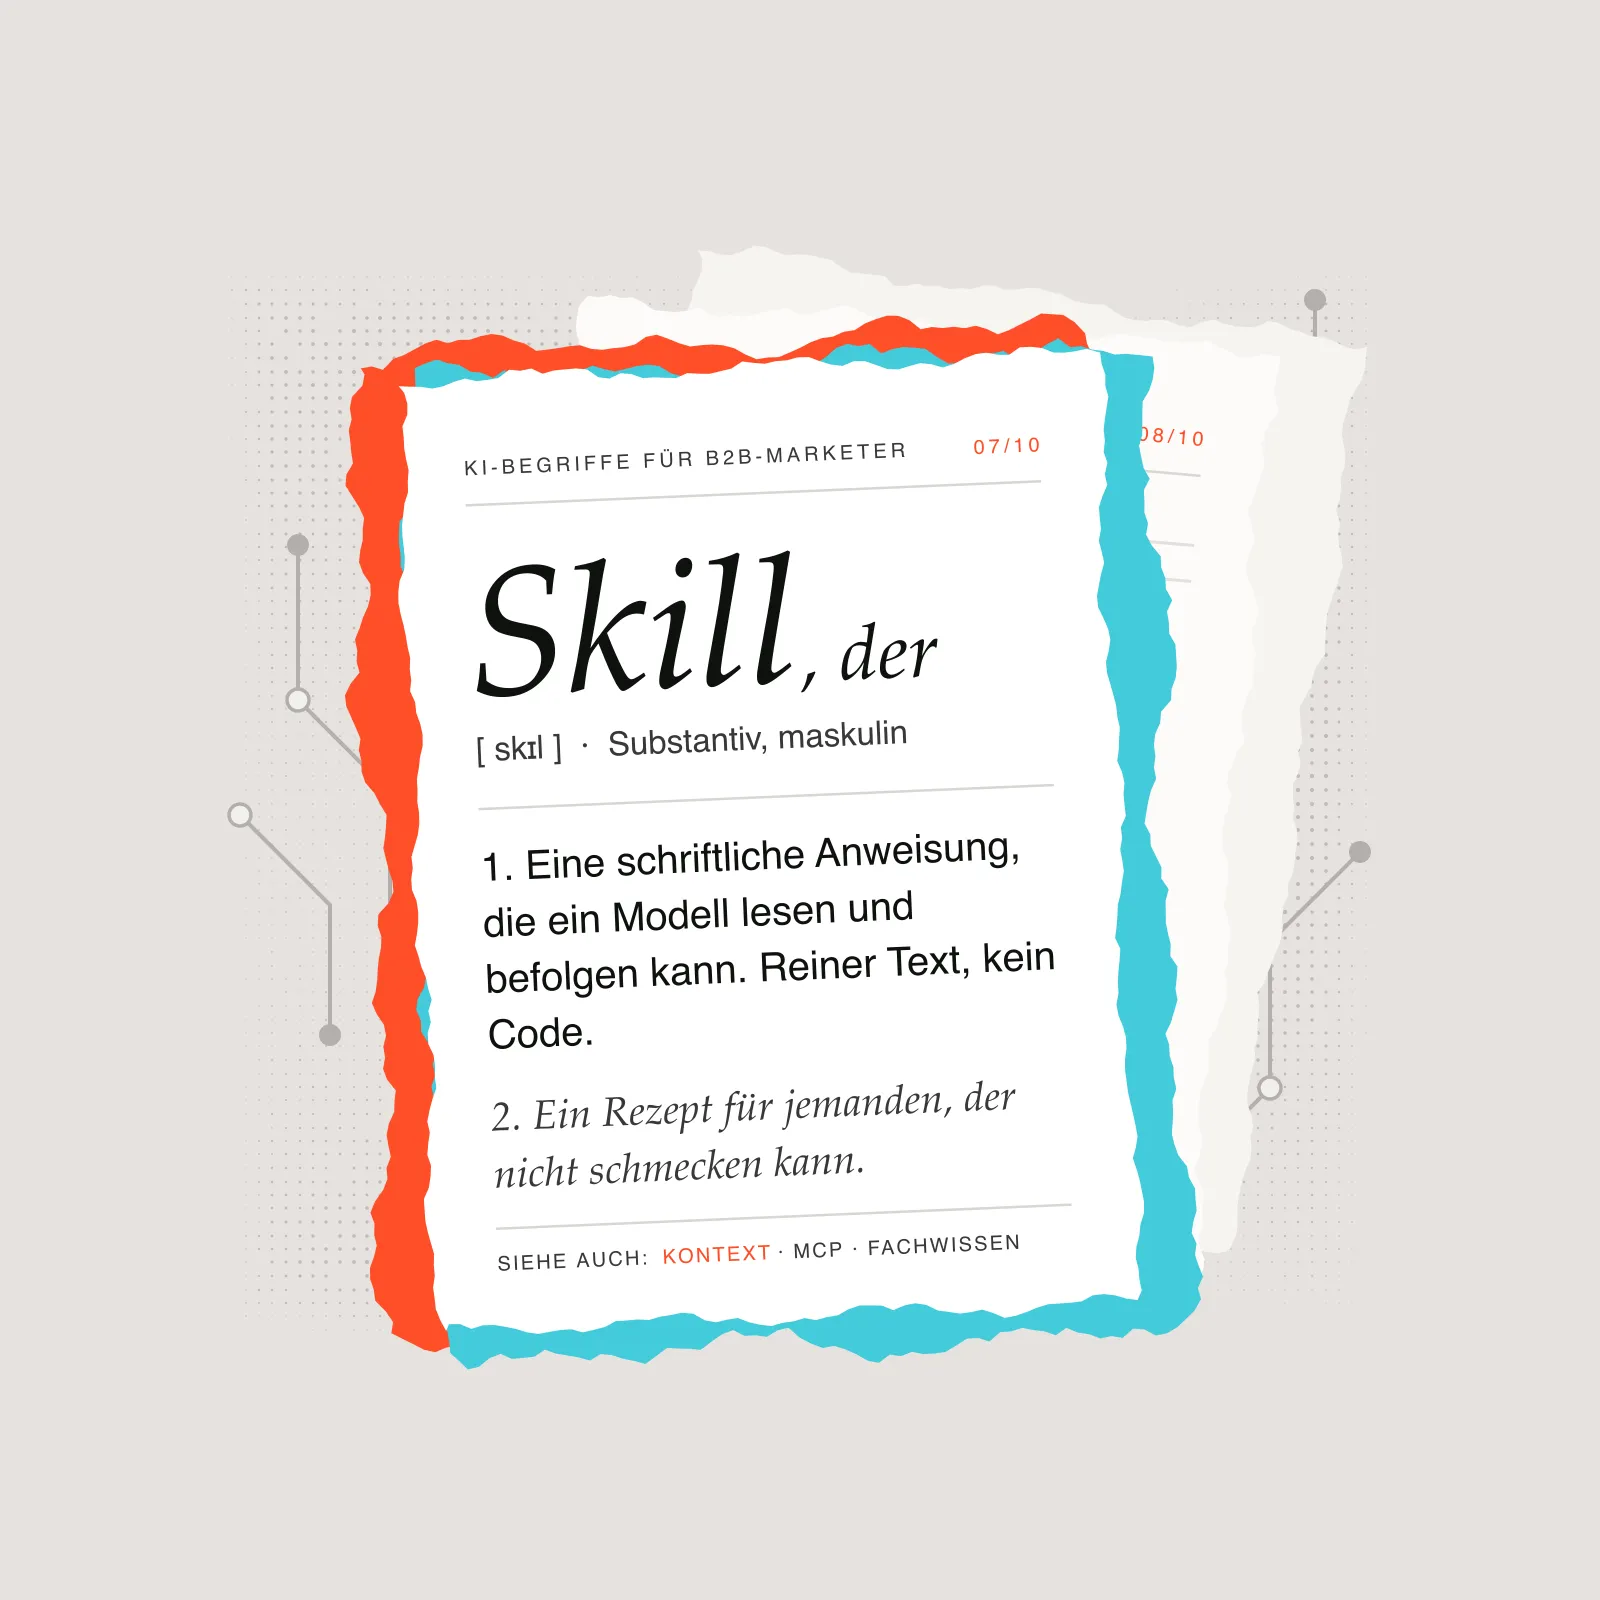
Ein Skill ist eine schriftliche Arbeitsanweisung, die ein Modell lesen und befolgen kann. Skills sind reiner Text im Markdown-Format, programmieren muss dafür niemand.
Ein Skill ist nicht komplizierter, als einem Praktikanten per Mail einen Prozess zu beschreiben: Das machen wir, in dieser Reihenfolge, und so sieht das Ergebnis aus, wenn es gut ist. Ein Kochrezept, geschrieben für jemanden, der nicht schmecken kann.
Was viele überrascht: Die Modelle entscheiden selbst, ob sie einen Skill benutzen. Bekommt das Modell eine Aufgabe und eine Bibliothek verfügbarer Skills, holt es sich den passenden und arbeitet die Anweisung in das ein, was es produziert.
Was ist Context Engineering?
Context Engineering heißt: entscheiden, was ein Modell sehen soll, bevor es antwortet. Es hat Prompt Engineering als die Disziplin abgelöst, die ein Marketing-Team im Haus aufbauen sollte.
Beim Prompt Engineering ging es um Formulierungen. Das war wichtig, als die Modelle schwächer waren, keine zusätzlichen Datenquellen hatten und empfindlicher darauf reagierten, wie man eine Frage stellt. Neuere Modelle verzeihen fast jede Formulierung, wissen über euer Geschäft aber genauso wenig wie die alten. Deshalb ist Context Engineering heute so wichtig und Prompt Engineering deutlich weniger.
Was ist MCP?
MCP, das Model Context Protocol, ist ein standardisierter Weg, über den sich ein KI-System während der Arbeit Informationen von woanders holt.
Viele Marketing-Teams tun sich damit schwer. Über MCP wird geredet, als wäre es die Erfindung, die generative KI überhaupt erst möglich gemacht hat. Dabei ist es nur die Leitung. Was durch die Leitung fließt, entscheidet über die Qualität eures KI-Outputs.
Ihr könntet Skill-Dateien auch an eine Mail hängen und alle bitten, sie von Hand in die KI ihrer Wahl zu kopieren. Das Ergebnis wäre dasselbe wie bei Skills, die über MCP verfügbar sind. Nur bricht der Prozess spätestens beim vierten Kollegen zusammen. MCP kann am Ende vor allem eins: externe Quellen effizient anbinden.
Was heißt es, KI in eure bestehenden Systeme zu integrieren, und warum interessiert das den Einkauf?
B2B-Marketing-Teams können KI direkt in ihre bestehenden Systeme integrieren. Dann nutzt ihr KI-Skills nativ in dem System, das eure Firma ohnehin schon fährt, statt auf der Plattform eines Anbieters, in die sich euer Team separat einloggt.
Das klingt nach einer technischen Vorliebe. Ist aber ziemlich wichtig, weil genau das den Einkauf umtreibt.
Will ein Marketing-Team ein neues Tool und muss dafür ein eigenständiges Produkt anschaffen, löst das die volle Beschaffungsmaschinerie aus: Due Diligence, IT-Sicherheitsprüfung, Datenschutz-Folgenabschätzung, DSGVO-Fragen, ein Gespräch mit dem Compliance-Beauftragten, und so weiter.
In den KI-Rollouts, die ich begleitet habe, dreht sich der größte Teil der Diskussion nicht darum, ob der Output gut ist. Sondern darum, wo die Modelle sitzen, ob sie in der EU oder in den USA gehostet werden und ob sensible Firmendaten das Haus verlassen.
Wenn die Architektur nur Wissen in ein System bringt, das solche Prüfungen längst bestanden hat, wird keine dieser Fragen neu aufgemacht.
Wer tiefer einsteigen will: Das Model Context Protocol aus dem MCP-Eintrag ist dokumentiert auf modelcontextprotocol.io.